Warum synthetische Imputation überhaupt ein Thema ist
Ein Klassiker der Marktforschung: Je umfangreicher ein Fragebogen thematisch werden soll, desto länger dauert das Interview – und mit zunehmender Dauer lässt die Sorgfalt der Antworten spürbar nach. Genau an diesem Punkt setzt Synthetic Data Imputation an, konkret umgesetzt im Fairgen-Tool IMPUTE: Anstatt jede Person das komplette Frageprogramm durchlaufen zu lassen, bekommt jeder Befragte nur einen Ausschnitt vorgelegt. Die restlichen, nicht gestellten Antworten werden im Anschluss statistisch geschätzt.
In einem mehrwöchigen Pilotprojekt hat AIDVISOR IMPUTE anhand zweier Szenarien geprüft: zum einen die Verkürzung langer Item-Batterien, zum anderen die Ergänzung ganzer Kategorie-Blöcke in Studien mit mehreren Produktkategorien. Die Ergebnisse fallen für beide Fälle unterschiedlich aus, woraus sich handfeste Praxisempfehlungen ableiten lassen.
Abgrenzung: IMPUTE und Synthetic Data Boost
Vorläufer von IMPUTE ist der Synthetic Data Boost: Hier wird ein bestehender Datensatz um zusätzliche, künstlich modellierte Fälle erweitert, um kleine Nischensegmente statistisch tragfähiger zu machen. Der zentrale Unterschied betrifft das, was verändert wird: Beim Boost kommen neue, synthetische Befragte hinzu, um dünn besetzte Stichproben aufzustocken. Bei IMPUTE bleibt die Zahl der Befragten unverändert – ergänzt werden stattdessen fehlende Zellen bei real teilnehmenden Personen, sodass jede Person am Ende mehr Antworten liefert, als ihr ursprünglich vorgelegt wurden.
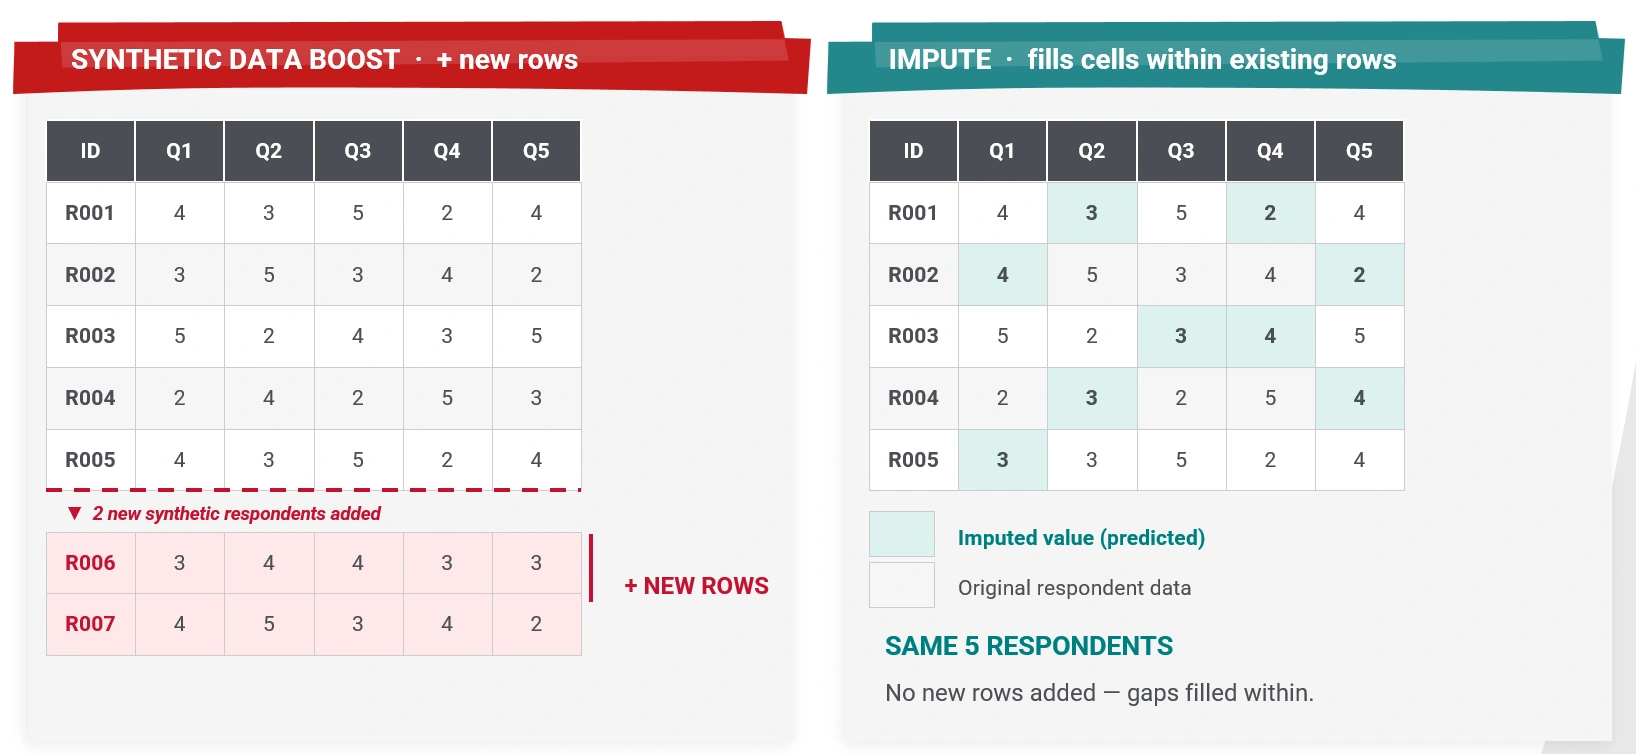
Abbildung 1: Synthetic Data Boost versus IMPUTE – der Boost ergänzt zusätzliche synthetische Befragte, IMPUTE füllt fehlende Antwortzellen real teilnehmender Personen auf.
Dadurch wird die Aufgabe ungleich komplexer: Ein Boost-Modell konstruiert vollständig neue, in sich geschlossene Interviews und muss lediglich auf die eigene generierte Logik achten. IMPUTE hingegen muss sich in bereits vorhandene, reale Antwortmuster einer Person einfügen – etwa hinsichtlich Skip-Logic und Routing, der Konsistenz im Funnel (wer eine Marke zuvor als „nicht bekannt" eingestuft hat, darf sie im nächsten Schritt nicht plötzlich „bevorzugen") sowie Abhängigkeiten zwischen Items innerhalb umfangreicher Matrizen. Diese Anforderungen machen die Validierung von IMPUTE grundsätzlich anspruchsvoller als beim reinen Boost-Ansatz – und begründen, warum ein eigenständiger Pilottest erforderlich war.
Der Ablauf von IMPUTE im Überblick
Der Prozess gliedert sich in fünf aufeinanderfolgende Schritte:
- Data Prep: einheitliche Benennung der Variablen und Kennzeichnung der zu ergänzenden Items
- Profiling: Beschreibung des Datensatzes und Prüfung, ob die fehlenden Werte zufällig verteilt sind (Missing-at-Random)
- Modelltraining: Der Algorithmus erlernt Zusammenhänge einzig auf Basis der vorliegenden Studiendaten, ganz ohne Sprachmodell
- Imputation: zeilenweise Vorhersage der fehlenden Werte
- Validierung: Abgleich der Ergebnisse mit tatsächlichen Werten aus einer zurückgehaltenen Testgruppe
Entscheidend dabei: IMPUTE arbeitet rein statistisch, ganz ohne Sprachmodell im Hintergrund. Das senkt das Risiko von Halluzinationen erheblich, macht das Verfahren im Gegenzug aber abhängig von einer hinreichend großen und qualitativ sauberen Datengrundlage.
Zwei Testszenarien im Pilotprojekt
Long Item Lists: 50 Items sollen erfasst werden, jede Person beantwortet aber nur 25 davon – die übrigen ergänzt IMPUTE. Grundlage war eine Kategorie- und Markenstudie mit n = 500 Teilnehmenden über 30 Kategorien hinweg. Pro Zeile wurden zufällig 33 %, 50 % beziehungsweise 66 % der Items ausgeblendet und anschließend gegen die übrige Stichprobe sowie einen separat zurückgehaltenen Testdatensatz geprüft. Voraussetzung dafür ist ein Ask-all-Design ohne komplizierte Filterführung sowie eine rein zufällige, nicht gefilterte Auslassung der Items.
Block Design: Hier wird nicht eine einzelne Liste gekürzt, sondern bei Studien mit mehreren Produktkategorien gleich ein kompletter Kategorie-Block weggelassen – eine Person beantwortet nur eine von zwei Produktkategorien vollständig, während IMPUTE die zweite vorhersagt. Das Interview verkürzt sich dadurch um nahezu die Hälfte, ohne dass die Kategorie-Abdeckung auf Aggregatebene leidet. Der Test erfolgte anhand von vier Kategorien mit Hide-Ratios von 33 % und 50 %, jeweils im Vergleich zu einer vollständig befragten Ground-Truth-Gruppe.
Ergebnisse: Solide bis zur 50-Prozent-Marke, danach steigt das Risiko
Über alle 30 Kategorien der Long-Item-List hinweg zeichnete sich ein eindeutiges Muster ab: Bei moderater Hide-Ratio kommt IMPUTE nah an die Trainingsdaten heran, mit wachsendem Anteil ausgeblendeter Items sinkt die Qualität jedoch merklich.
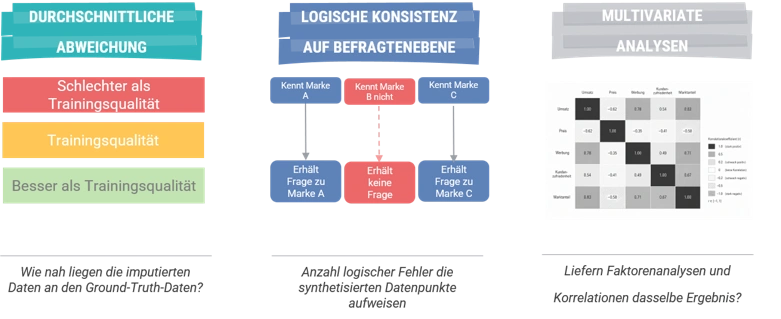
Abbildung 2: Qualität der imputierten Werte in Abhängigkeit von der Hide-Ratio (Long Item List, 30 Kategorien, n = 500).
Quellenwahl schlägt Toolgläubigkeit
- Innerhalb des Konfidenzintervalls der Trainingsdaten lagen bei 33 % Hide-Ratio 80,1 % der imputierten Werte, bei 50 % noch 67,2 % und bei 66 % nur noch 52,9 %.
- Logische Fehler in Funnel oder Filterführung fielen insgesamt gering aus: 1,73 % bei einer Hide-Ratio von 33 % und 3,61 % bei 66 %.
- Deutlicher fällt der Qualitätsverlust bei multivariaten Auswertungen aus: Während der Referenzwert stabil bei rund 8,5 liegt, sinkt die Korrelationsstärke auf 6,45 (33 %), 4,72 (50 %) und schließlich 2,00 (66 %). Auch die durchschnittliche Korrelation der Faktorladungen mit der Ground Truth nimmt ab – von 0,932 im Training auf 0,731 bei 33 % Hide-Ratio und weiter auf 0,582 bei 50 %.
- Bei geringer Hide-Ratio lassen sich imputierte Werte kaum von echten Antworten unterscheiden (AUC 51 % bei 33 %), mit zunehmendem Anteil werden sie jedoch deutlich erkennbarer (AUC 74 % bei 66 %).
Beim Block Design ergibt sich ein ähnliches, aber differenzierteres Bild: Auch hier nehmen Abweichung und Fehlerquote mit steigender Hide-Ratio zu, die Faktorstruktur bleibt jedoch spürbar stabiler als bei der Long Item List. Bei 33 % Hide-Ratio liegen Trainings- und Imputationsdaten fast gleichauf (Ø r 0,766 gegenüber 0,754 – statt einer Differenz von 0,201 wie bei der Long Item List). Im Gegenzug lässt sich Block Design leichter als synthetisch identifizieren (AUC 60–77 % je nach Kategorie, verglichen mit 51–58 % bei der Long Item List).
Voraussetzungen für einen erfolgreichen Einsatz
Aus den beiden Pilotprojekten lassen sich drei zentrale Erfolgsfaktoren ableiten:
- Stichprobengröße: mindestens n = 200 echte, vollständig ausgefüllte Datenpunkte, bei 33 % Hide-Ratio eine Mindeststichprobe von n = 300.
- Hide-Ratio: Für multivariate Berechnungen sollte 33 % nicht überschritten werden, für rein deskriptive Auswertungen liegt die Grenze bei 50 %. Jenseits dieser Werte steigen Fehlerquote und Erkennbarkeit deutlich an.
- Fragebogenlogik: Am besten eignen sich einfache Ask-all-Blöcke ohne Routing, wobei die Auslassung zufällig erfolgen muss – lange, aber schlicht aufgebaute Fragebögen lassen sich zuverlässiger vorhersagen als lange, komplexe.
Eignung im Vorfeld testen
Ob sich IMPUTE für einen konkreten Datensatz eignet, lässt sich schon vor der eigentlichen Studie einschätzen: Empfehlenswert ist ein Vorabtest an einer strukturell ähnlichen, bereits bestehenden Studie, bei dem ein Teil der echten Antworten zurückgehalten, per IMPUTE geschätzt und anschließend mit den Echtwerten verglichen wird. Dabei zählen drei Ebenen: die Abweichung von der Ground Truth (Anteil der Werte innerhalb des Konfidenzintervalls, Zielmarke mindestens 75 %), die logische Konsistenz auf Ebene der einzelnen Befragten (Anteil inkonsistenter Interviews, grüner Bereich unter 2 %) sowie die Stabilität multivariater Kennzahlen wie Faktorladungen (Ø r mindestens 0,75, Abstand zu den Trainingsdaten höchstens 0,05). Für rein deskriptive Studien reicht es, wenn die ersten beiden Ebenen im grünen Bereich liegen; sind multivariate Analysen geplant, muss zusätzlich die dritte Ebene erfüllt sein.
Grenzen des Verfahrens
- Auf aggregierter Ebene plausibel, auf Einzelinterview-Ebene nicht immer stimmig: Mit steigender Hide-Ratio nehmen logische Fehler innerhalb einzelner Interviews merklich zu.
- Segmentierungen oder Treiberanalysen auf Grundlage imputierter Daten sind nicht zu empfehlen, da die Konsistenz auf Befragtenebene dafür nicht ausreicht.
- Demografische Merkmale und Profiling-Variablen gehören grundsätzlich nicht zu den Größen, die imputiert werden sollten.
- Bei stark gefilterten oder verzweigten Fragebögen führt komplexe Filterlogik zu ungenaueren Vorhersagen.
Anwendungsfelder in der Praxis
Umfangreiche Item-Batterien – etwa Importance-/Fulfillment-Matrizen oder U&A-Abfragen – lassen sich mit IMPUTE kürzen, ohne dass die inhaltliche Abdeckung leidet. Auch bei Multi-Kategorie-Studien, in denen mehrere Produktkategorien abgefragt werden sollen, aber niemand alle davon vollständig beantworten muss, kann das Verfahren unterstützen. Ebenso bewähren sich nach bisheriger Erfahrung Pipe-in-Abschnitte, etwa beim Einspielen von Marken.
Grenzen des Nutzens: Was IMPUTE nicht ersetzt
Genau wie beim Synthetic Data Boost gilt auch hier: Echte Interviews bleiben die zuverlässigste Datenquelle. IMPUTE ist kein Mittel zur Kostensenkung, sondern soll Interviews kürzer und weniger belastend machen – nicht das Budget schonen. Vor jedem produktiven Einsatz lohnt sich deshalb ein eigener Pilottest mit den jeweiligen Studiendaten.
Fazit
IMPUTE zeigt, dass sich das altbekannte Dilemma langer Fragebögen – mehr Themenabdeckung versus kürzere Interviews – zumindest teilweise entschärfen lässt. In beiden getesteten Szenarien liefert eine moderate Hide-Ratio von bis zu 50 % brauchbare bis gute Resultate auf aggregierter Ebene. Das Block Design bewahrt dabei die inhaltliche Faktorstruktur besser, lässt sich im Gegenzug aber leichter als synthetisch erkennen als das Auffüllen einzelner Items in langen Listen. Für die Praxis bedeutet das: Welcher Ansatz sich eignet, sollte an der jeweiligen Fragestellung entschieden werden – und in jedem Fall an einem eigenen Pilottest mit realistischen Erwartungen.